На учебном разборе логистической регрессии таблица с ценами и характеристиками жилья быстро обнаруживает главную трудность: число признаков растёт, а ответ всё равно нужен в форме «подходит» или «не подходит». Когда читатель планирует купить квартиру в Москве недорого, статистическая модель может не искать объект вместо него, а оценивать вероятность того, что объявление проходит заранее заданный порог доступности. Связь здесь практическая: ограничения бюджета превращаются в целевую переменную, параметры объекта становятся признаками, а результат модели упорядочивает проверку. Но точность отбора зависит не от количества столбцов, а от смысла данных, способа кодирования и честного разбора ошибок.
Как модель отвечает на вопрос о доступности
Логистическая регрессия нужна тогда, когда наблюдение требуется отнести к одному из двух классов. В задаче с жильём классами могут быть «доступно для заданного бюджета» и «не доступно», «заслуживает подробного просмотра» и «не проходит первичный фильтр». Модель не выдаёт готовую истину. Она рассчитывает вероятность принадлежности к выбранному классу, после чего исследователь применяет порог и получает решение.
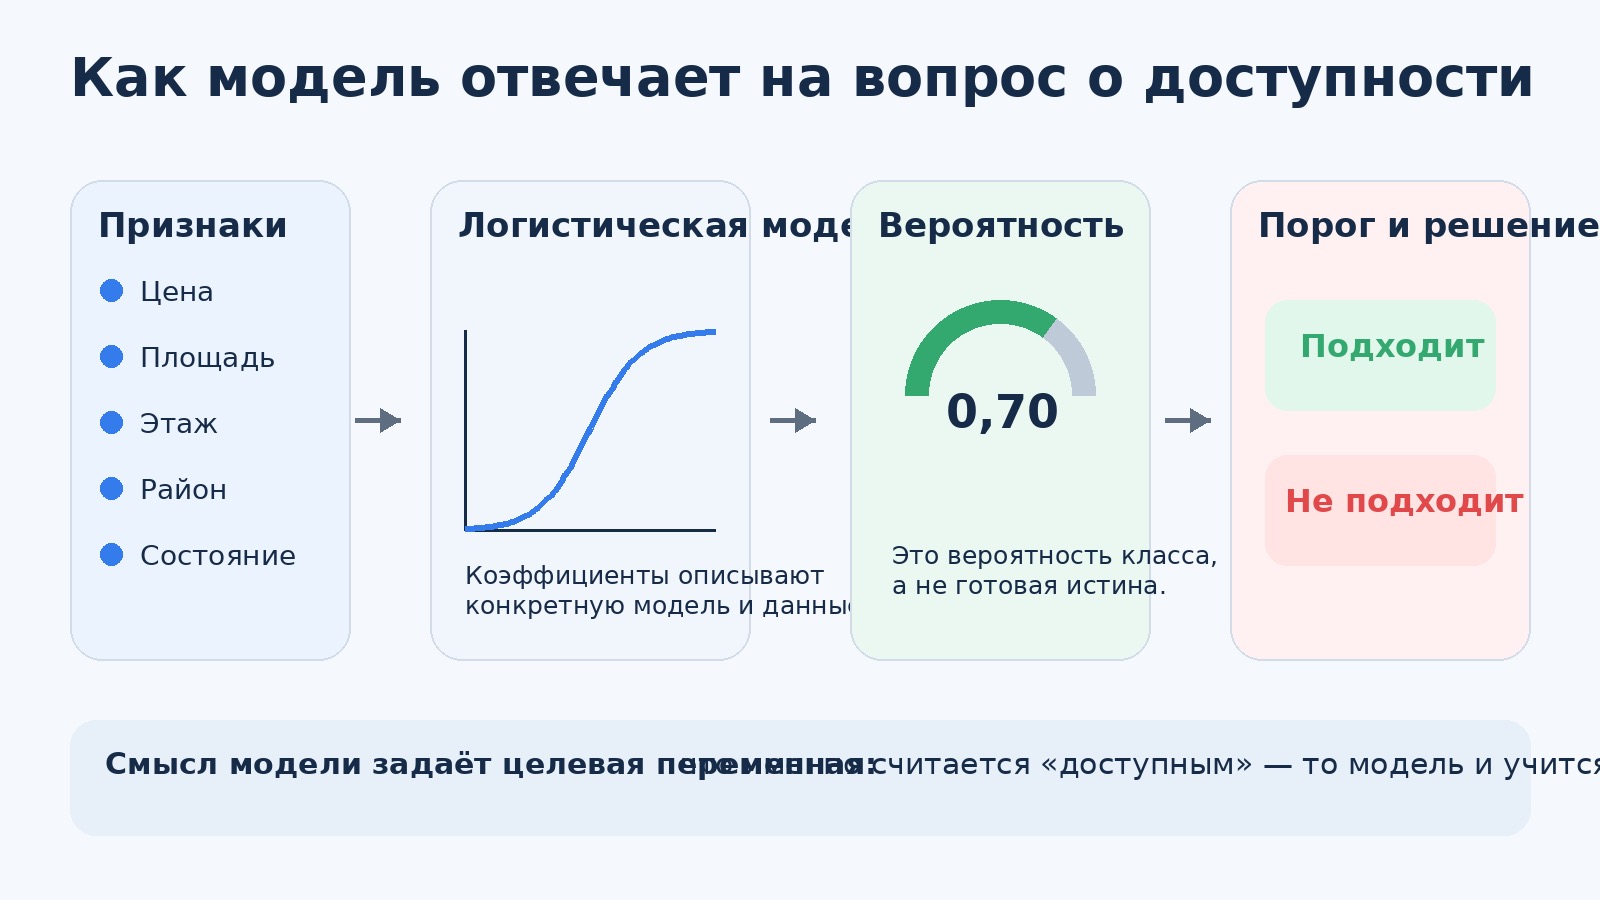
Именно определение класса задаёт смысл всей работы. Если доступность обозначена только общей ценой квартиры, модель ответит на узкий вопрос о соответствии верхней границе бюджета. Для реального покупателя этого часто мало: объект с приемлемой ценой может потребовать расходов на ремонт, иметь неудобную планировку или создавать тяжёлую долговую нагрузку. Тогда целевую переменную формируют по более содержательному правилу, но правило должно применяться ко всем строкам одинаково.
Допустим, учебная таблица содержит архивные объявления и рассчитанный для каждого объекта допустимый предел полной стоимости. Строка получает единицу, если цена вместе с заранее оценёнными обязательными расходами не превышает предел, и ноль в остальных случаях. Это условный пример, а не рыночная статистика. Его ценность в другом: исследователь видит, кто назначает класс и какие предположения уже встроены в ответ.
Логистическая регрессия связывает признаки с логарифмом отношения шансов. Такая формулировка непривычна при первом чтении, поэтому результат нередко ошибочно трактуют как обычную линейную зависимость. Коэффициент не говорит, на сколько процентных пунктов обязательно изменится вероятность при увеличении признака на единицу. Он показывает, как меняется отношение шансов при прочих равных условиях, а влияние на вероятность зависит от исходного уровня и сочетания остальных признаков.
Знак коэффициента прочитать проще. Положительное значение указывает, что рост признака связан с увеличением шанса попасть в целевой класс, отрицательное — с уменьшением. Однако и здесь нужна осторожность. Если целевой класс обозначает доступность, увеличение площади при неизменных прочих характеристиках может получить отрицательный коэффициент из-за связи площади с полной ценой. Но после добавления цены за единицу площади, состояния отделки и типа объекта величина способна измениться. Коэффициенты описывают конкретную модель, а не вечные свойства рынка.
На экране такая модель выглядит сухо: столбцы, знаки, несколько длинных десятичных дробей. За каждой строкой всё же стоит квартира с определённой площадью, этажом и состоянием, а за целевой переменной — решение человека, который ограничен суммой и временем. Стоит изменить определение доступности, и та же таблица начнёт отвечать уже на другой практический запрос.
Данные начинают работать до расчёта коэффициентов
Подготовка данных влияет на результат сильнее, чем выбор красивого способа представить итоговую вероятность. Дубли объявлений, пропуски и неодинаковые единицы измерения искажают выборку ещё до запуска расчёта. Если один объект указан несколько раз после изменения цены, модель может принять повторение за несколько независимых наблюдений. Яркие фотографии тут ничего не исправят: в таблице останутся почти одинаковые строки.
Сначала определяют единицу наблюдения. Ею может быть объявление на конкретную дату, отдельный объект или завершённая сделка, если такие сведения законно получены и подходят для исследования. Смешивать эти сущности опасно. Цена предложения не равна цене сделки, а повторно опубликованное объявление не становится новой квартирой только из-за иной даты выгрузки.
Набор признаков выбирают по моменту, когда модель должна применяться. Если она сортирует свежие объявления, в обучающей таблице нельзя использовать сведения, появляющиеся после продажи или снятия объекта с публикации. Такая утечка данных создаёт впечатление высокой точности, но при работе с новыми строками качество резко падает. Модель словно заглядывает в последнюю страницу задачи, а затем выдаёт это за умение рассуждать.
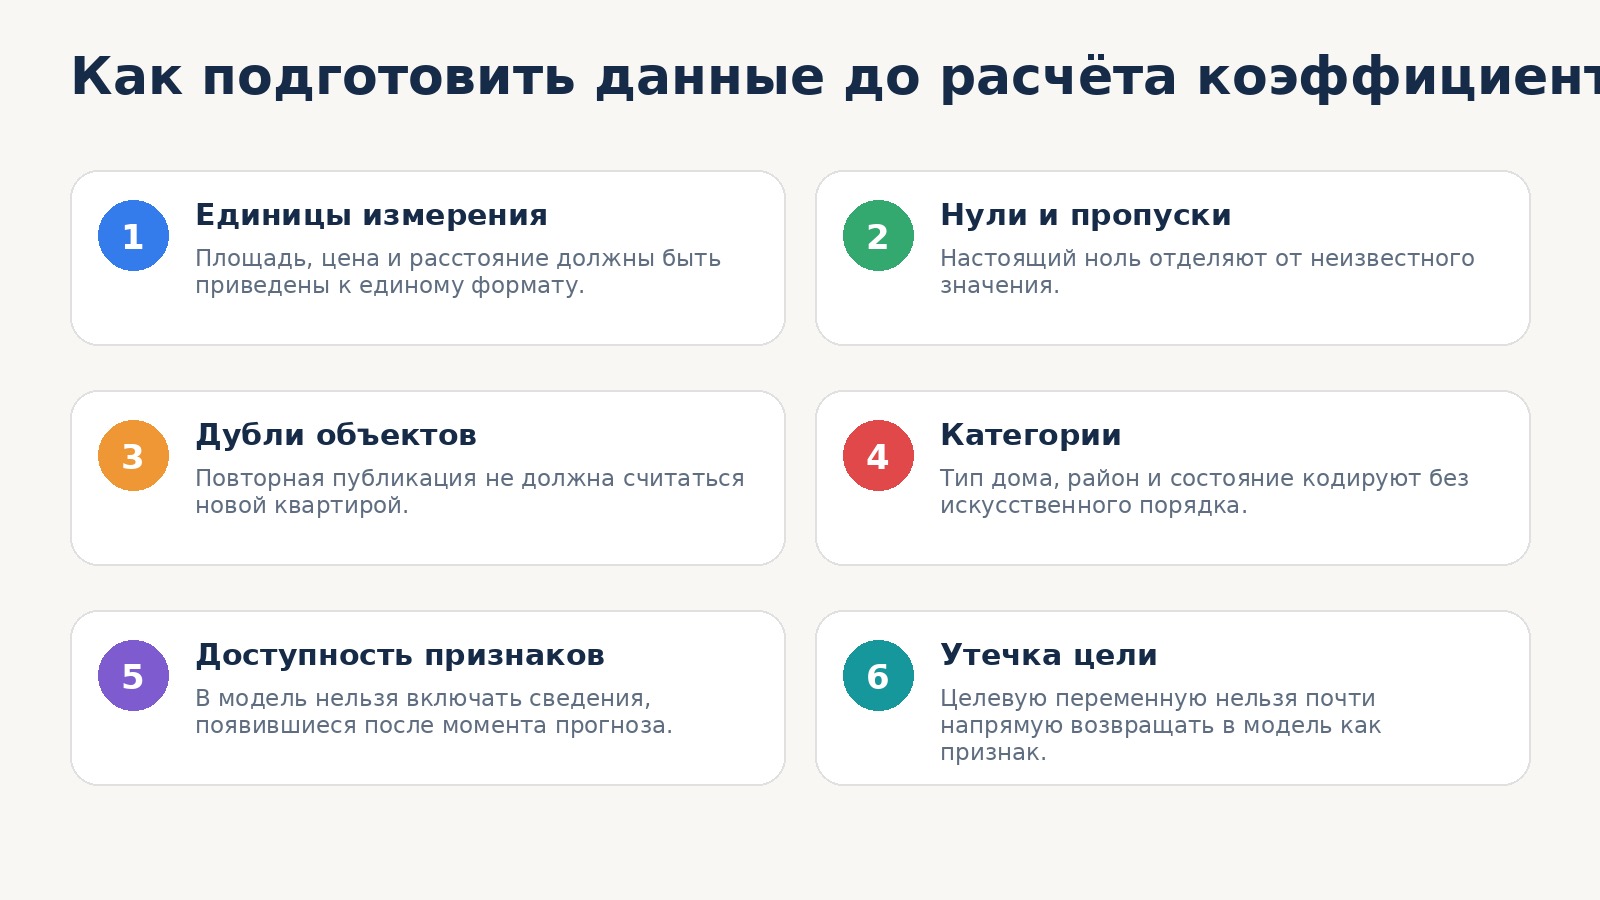
Перед построением модели полезно проверить следующие элементы таблицы:
- совпадают ли единицы площади, цены и расстояния во всех строках;
- отделены ли настоящие нулевые значения от неизвестных данных;
- не повторяется ли один объект под разными обозначениями;
- были ли категориальные признаки закодированы без искусственного порядка;
- доступен ли каждый признак в момент, для которого рассчитывается прогноз;
- не сформирована ли целевая переменная из признака, который затем снова подаётся модели почти без изменения.
Категориальные характеристики требуют отдельного кодирования. Нельзя присвоить типам домов числа от одного до четырёх и обращаться с ними как с естественной шкалой, если между категориями нет содержательного порядка. Числовая запись заставит модель считать разницу между соседними кодами одинаковой. Корректнее создать отдельные двоичные индикаторы, выбрав одну категорию в качестве сравнительной.
Пропуски нельзя автоматически заменять нулём. Нулевая площадь кухни означает физически странную характеристику, а отсутствие значения сообщает лишь о неполной строке. Иногда пропуск сам несёт информацию: продавцы могут реже указывать параметр у объектов определённого типа. Тогда добавляют индикатор отсутствия и отдельно выбирают способ заполнения. Такое действие фиксируют в описании исследования, иначе повторить расчёт будет трудно.
Утром после обновления выгрузки таблица часто выглядит вполне аккуратно, пока сортировка по площади не выносит наверх объект с лишним нулём. Одна такая строка способна заметно сдвинуть коэффициент, особенно в небольшой учебной выборке. Диаграмма распределения и просмотр крайних значений занимают меньше времени, чем последующее объяснение нелепого результата.
Период наблюдения тоже имеет смысл. Данные, собранные в разные фазы рынка, могут отражать неодинаковую связь между ценой, сроком публикации и характеристиками объекта. Случайное перемешивание строк скрывает этот сдвиг. Для задачи, ориентированной на будущие объявления, проверочную часть разумнее отделять по времени: более ранние наблюдения идут в обучение, поздние показывают, сохранилась ли найденная закономерность.
Коэффициенты, порог и цена ошибочного решения
Интерпретация начинается не с просмотра знаков, а с проверки масштаба признаков и выбранной сравнительной категории. Коэффициент площади, измеренной в квадратных метрах, нельзя напрямую сопоставлять с коэффициентом цены, записанной крупными денежными единицами. Различный масштаб не делает признак сильнее или слабее, но мешает поверхностному сравнению чисел. Для учебного анализа признаки иногда стандартизируют, сохраняя исходные величины для понятного объяснения результата.
Отношение шансов получают возведением основания натурального логарифма в степень, равную коэффициенту. Если оно больше единицы, шанс целевого исхода растёт; если меньше единицы, снижается. Интервал неопределённости показывает, насколько устойчиво это направление в пределах выбранной модели и данных. Широкий интервал часто появляется при малом числе наблюдений, редкой категории или сильной связи между несколькими признаками.
Связанные признаки создают неприятную сцену: модель в целом сортирует объекты приемлемо, но отдельные коэффициенты меняют знак при небольшом изменении набора столбцов. Полная цена, площадь и цена за единицу площади математически зависят друг от друга. Если без разбора включить их вместе, интерпретация распадается. Один из признаков убирают либо заранее выбирают параметр, который ближе к содержанию задачи.
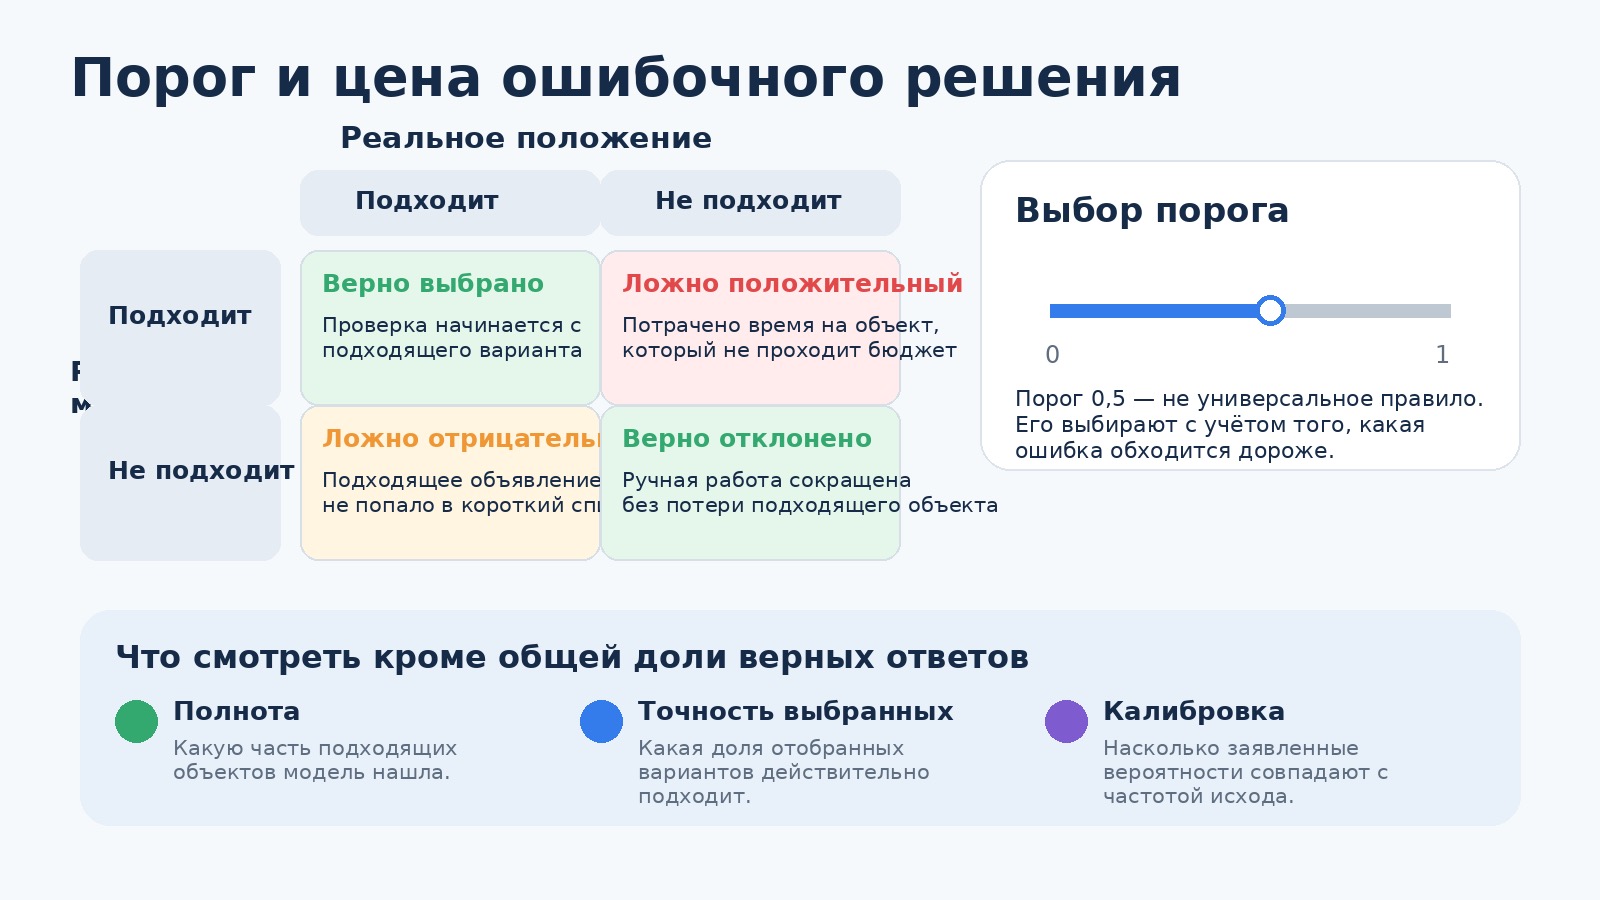
Вероятность становится классом только после выбора порога. Значение в половину часто используют по привычке, хотя оно не обязано соответствовать расходам покупателя. Если модель нужна для короткого списка, слишком низкий порог наполнит его слабыми вариантами. Слишком высокий отсечёт редкие объекты, которые стоило изучить вручную. Настройка зависит от того, какая ошибка обходится дороже.
Ошибки модели следует связывать с наблюдаемыми последствиями:
|
Результат модели |
Реальное положение |
Практическое последствие |
|---|---|---|
|
Объект признан доступным |
Полная нагрузка выше принятого предела |
Человек тратит время на проверку варианта, который не выдерживает расчёта расходов |
|
Объект отклонён |
Он проходит заданные ограничения |
Подходящее объявление не попадает в короткий список |
|
Объект признан доступным |
Он действительно соответствует правилу |
Проверка документов и состояния начинается с содержательно подходящего варианта |
|
Объект отклонён |
Он не соответствует правилу |
Ручная работа сокращается без потери подходящего объекта |
Долю верных ответов нельзя считать достаточной характеристикой, особенно если классы распределены неравномерно. Когда доступных объектов мало, модель может почти всегда предсказывать отказ и всё равно показывать высокую общую долю совпадений. Полезнее раздельно смотреть, какую часть подходящих объектов она нашла и какая доля выбранных ею вариантов оказалась подходящей. Названия показателей менее значимы, чем понимание их знаменателей.
Порог выбирают на проверочной выборке, а окончательное качество оценивают на данных, которые не участвовали ни в обучении, ни в настройке. Иначе исследователь подгоняет не только коэффициенты, но и правило принятия решения. Тут возникает тихая ловушка: десятки вариантов порога просматриваются глазами, лучший запоминается, и проверочная часть незаметно превращается в учебную.
Вероятности нуждаются и в проверке согласованности. Среди объектов с прогнозом около семидесяти процентов целевой исход должен встречаться примерно с сопоставимой частотой на достаточно большом наборе наблюдений. Если модель регулярно выдаёт уверенные оценки, которые не подтверждаются, её ранжирование ещё может быть полезным, но числа нельзя подавать как достоверную вероятность без дополнительной настройки.
Штраф за сложность удерживает коэффициенты от чрезмерного роста, когда признаков много или они тесно связаны. Он часто улучшает устойчивость прогноза, однако меняет трактовку оценок: коэффициенты сознательно сжимаются. Поэтому модель для объяснения связей и модель для сортировки объявлений могут требовать разных настроек. Совпадение этих задач возможно, но не гарантировано.
Как применять вероятность при отборе квартиры
Модель разумно использовать как фильтр очереди, а не как замену осмотру, финансовому расчёту и юридической проверке. Она способна обработать однородные табличные характеристики и поднять выше объявления, похожие на ранее признанные доступными. Скрытые дефекты, содержание документов и состояние подъезда в такой таблице обычно отсутствуют либо описаны слишком грубо.
Практическая работа начинается с личного определения доступности. Верхняя граница цены сама по себе не учитывает запас после покупки, обязательные платежи и расходы, без которых объект нельзя использовать по назначению. Если эти составляющие доступны только в виде приблизительной оценки, их не следует маскировать точными числами. Лучше построить несколько сценариев и посмотреть, насколько устойчиво место объекта в списке.
Например, квартира получает высокую вероятность пройти бюджетный фильтр. После добавления предполагаемых расходов на базовые работы оценка резко снижается. Это не означает, что модель обнаружила скрытый дефект: изменились входные условия. Пользователю нужен не один эффектный процент, а пояснение, какие признаки сильнее всего повлияли на конкретный результат и чего в данных нет.
Порядок просмотра объявлений можно строить по вероятности, оставляя рядом исходные значения ключевых признаков. Голый рейтинг быстро становится непрозрачным. Когда возле оценки видны цена, площадь, состояние и расхождение с установленным пределом, человек замечает странности: маленький объект оказался наверху из-за пропуска или редкая категория получила чрезмерно большой коэффициент.
Мало кто одинаково оценивает две ошибки. Покупателю с жёстким бюджетом может быть неприятнее потратить вечер на заведомо неподъёмный объект. При дефиците времени для поиска опаснее пропустить редкое подходящее предложение. Порог следует менять под эту разницу, а не объявлять одну границу универсальной.
После первичной сортировки модель отступает на второй план. Проверяются правовой статус объекта, полномочия стороны, содержание договора, фактическое состояние помещений и совпадение характеристик с документами. Эти сведения не стоит автоматически собирать в учебный набор без законного основания: часть информации относится к персональным данным, часть появляется лишь на поздней стадии проверки.
На осмотре табличная строка быстро приобретает фактуру. Холод от наружной стены, гул инженерного оборудования или следы влаги возле откоса могут изменить оценку расходов сильнее, чем небольшое преимущество в прогнозе. Никакой коэффициент не видел эти детали, если они не были зафиксированы единообразно и до принятия решения.
Обратная связь после ручной проверки полезна, но её нельзя бездумно возвращать в обучение. Если проверялись только объекты с высокой модельной оценкой, сведения о нижней части списка останутся неизвестными. Новая выборка окажется зависимой от старой модели, и та начнёт подтверждать собственные предпочтения. Часть объектов приходится отбирать случайно или по отдельному правилу, чтобы контролировать такое смещение.
Повторное обучение имеет смысл после накопления достаточного числа новых, сопоставимых наблюдений или при заметном изменении качества. Календарный запуск каждую неделю не улучшает модель автоматически. Сначала сравнивают распределения признаков, доли пропусков и частоту целевого класса. Если изменился способ публикации данных, прежняя схема обработки может дать сбой даже без перемен в поведении рынка.
Что формула оставляет за границей таблицы
Логистическая регрессия особенно полезна своей прозрачностью: исследователь видит признаки, направление связей и правило перехода от вероятности к классу. Эта прозрачность не отменяет ограничений. Модель воспроизводит определение целевого исхода, структуру выборки и ошибки измерения. Если доступность сведена к одной цене, результат не охватит расходы после покупки; если данные относятся лишь к опубликованным предложениям, выводы нельзя автоматически переносить на все сделки.
Полезно хранить не только итоговые коэффициенты, но и описание подготовки: дату среза, правило удаления повторов, способ обработки пропусков, перечень исключённых столбцов и границу класса. Без такого журнала даже знакомая модель через несколько месяцев становится чужой. Названия признаков остаются на месте, а смысл расчёта уже приходится восстанавливать по обрывкам файлов.
Проверка устойчивости добавляет больше пользы, чем ещё один декоративный показатель. Модель пересчитывают при разумных вариантах определения бюджета, на разных временных отрезках и после удаления подозрительных строк. Если короткий список полностью меняется от небольшой поправки, результат следует показывать как неустойчивый. Иногда честная отметка неопределённости ценнее точного числа после запятой.
Выбор квартиры всё-таки не сводится к классификации. Статистика снимает часть монотонной работы, обнаруживает противоречия в критериях и заставляет заранее назвать цену ошибки. Дальше возвращается предметная проверка: документы читают, расходы пересчитывают, помещение осматривают без спешки. Если прогноз расходится с тем, что видно в исходных данных и на месте, сохраняют не уверенность модели, а причину расхождения — именно из таких записей затем получается более честная учебная задача.